
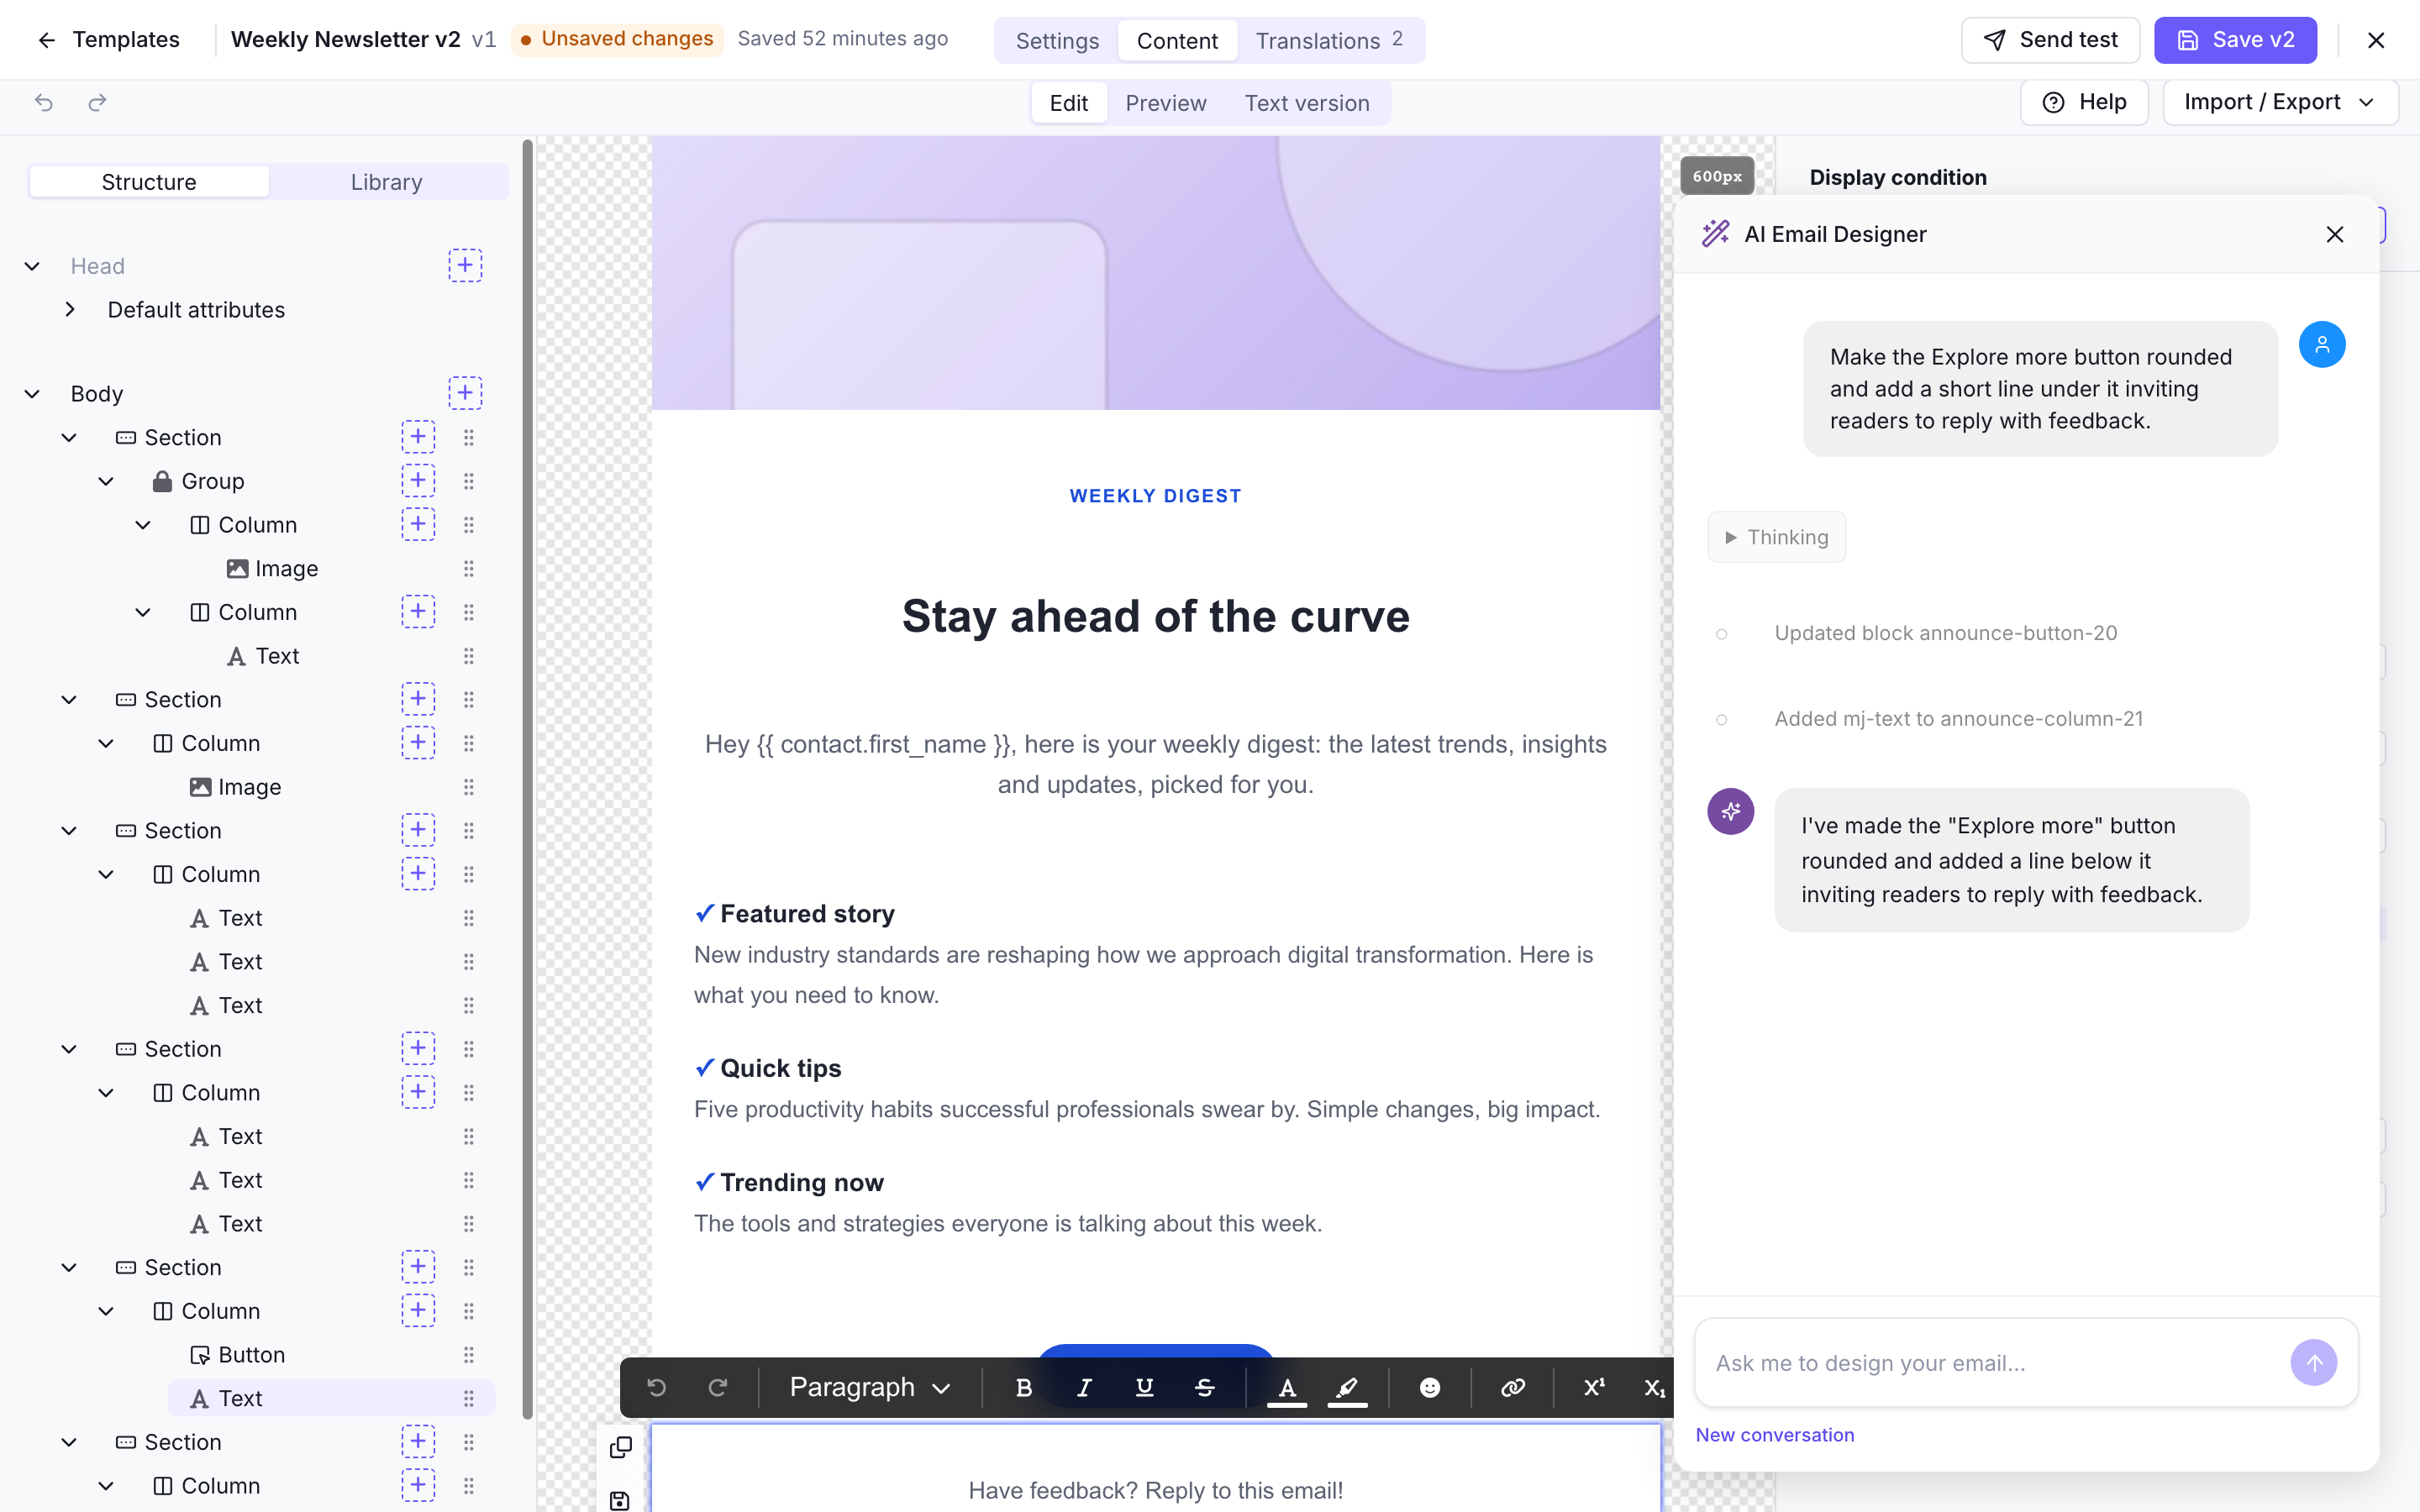
O Notifuse tem um assistente de IA dentro das ferramentas que você já usa. Ele escreve e edita posts do blog, monta templates de email bloco a bloco e responde a perguntas sobre o tráfego do seu site. Com o Firecrawl configurado, ele também pode pesquisar na web e ler páginas antes de escrever.
Ele funciona com a sua própria chave do provedor. O seu servidor chama a Anthropic, a OpenAI ou o Gemini diretamente, e é esse provedor que cobra de você. O Notifuse não revende créditos de IA nem passa os seus prompts por um serviço hospedado.
Configuração
- Vá em Configurações → Integrações, clique em Adicionar integração e escolha um provedor em Assistente de IA.
- Escolha um provedor de LLM (Anthropic, OpenAI ou Gemini) e informe a sua chave API e o modelo.
- Se quiser, adicione o Firecrawl para dar acesso à web ao assistente.
Nota
Só os proprietários do workspace podem adicionar ou editar integrações. As chaves API são criptografadas antes de serem armazenadas. Enquanto não existir uma integração de LLM, o painel do assistente mostra um link para a página de configurações no lugar da caixa de chat.
Usar o assistente exige a permissão de escrita de LLM. A leitura de LLM não libera nada hoje (o chat é o único endpoint de LLM e depende da escrita), então o console a mostra concedida e bloqueada. Cada conversa gasta os créditos do seu próprio provedor, e as ferramentas do Firecrawl rodam no seu servidor com as suas credenciais, então trate a escrita de LLM como uma permissão de gasto. Veja Administradores e chaves API.
Onde encontrar
| Superfície | Onde | O que faz |
|---|---|---|
| Designer de e-mails com IA | O editor de templates de email, no modo visual | Monta e edita o email: blocos, layout, estilos, assunto e texto de pré-visualização |
| Assistente IA para Blog | O editor de posts do blog | Escreve o corpo do artigo, além do título, do resumo e dos metadados de SEO e Open Graph |
| Assistente de Analytics | Dashboard, Explorar e Metas | Responde a perguntas sobre o seu tráfego, resume um período e controla o dashboard |
Cada um abre por um botão no seu editor e já conhece o que está na tela (a árvore do email atual, o post atual, o período e os filtros atuais). Assim, pedidos como “deixe o cabeçalho mais compacto” ou “por que a semana passada caiu” não precisam de mais contexto.
Criar templates de email
O assistente de email trabalha na mesma árvore de blocos do editor visual, então tudo o que ele produz pode ser editado à mão depois.
| Ele pode | Exemplo |
|---|---|
| Criar um template do zero | “Crie um email de lançamento de produto com um hero, três colunas de recursos e um CTA” |
| Editar blocos existentes | “Deixe o botão verde e com largura total no celular” |
| Adicionar, excluir, mover e reordenar blocos | “Coloque o depoimento acima da seção de preços” |
| Definir o assunto e o texto de pré-visualização | “Escreva três assuntos para este email e use o melhor” |
| Selecionar um bloco para você vê-lo | Ele destaca no editor o que acabou de mudar |
Ele também segue a categoria do template. Um template de marketing sempre termina com um rodapé que traz os links de descadastro e de preferências. Um transacional não recebe link de descadastro, porque um envio pela API não tem lista da qual sair. Um de confirmação dupla recebe o botão de confirmação.
Depois de cada edição, o MJML é compilado e qualquer erro aparece na conversa, então uma geração com problema nunca aparece como sucesso.
Nota
O assistente de email só está disponível no editor visual. Os templates escritos no modo de código MJML não mostram o painel, porque o assistente edita a árvore de blocos, e não o código-fonte.
Escrever posts do blog
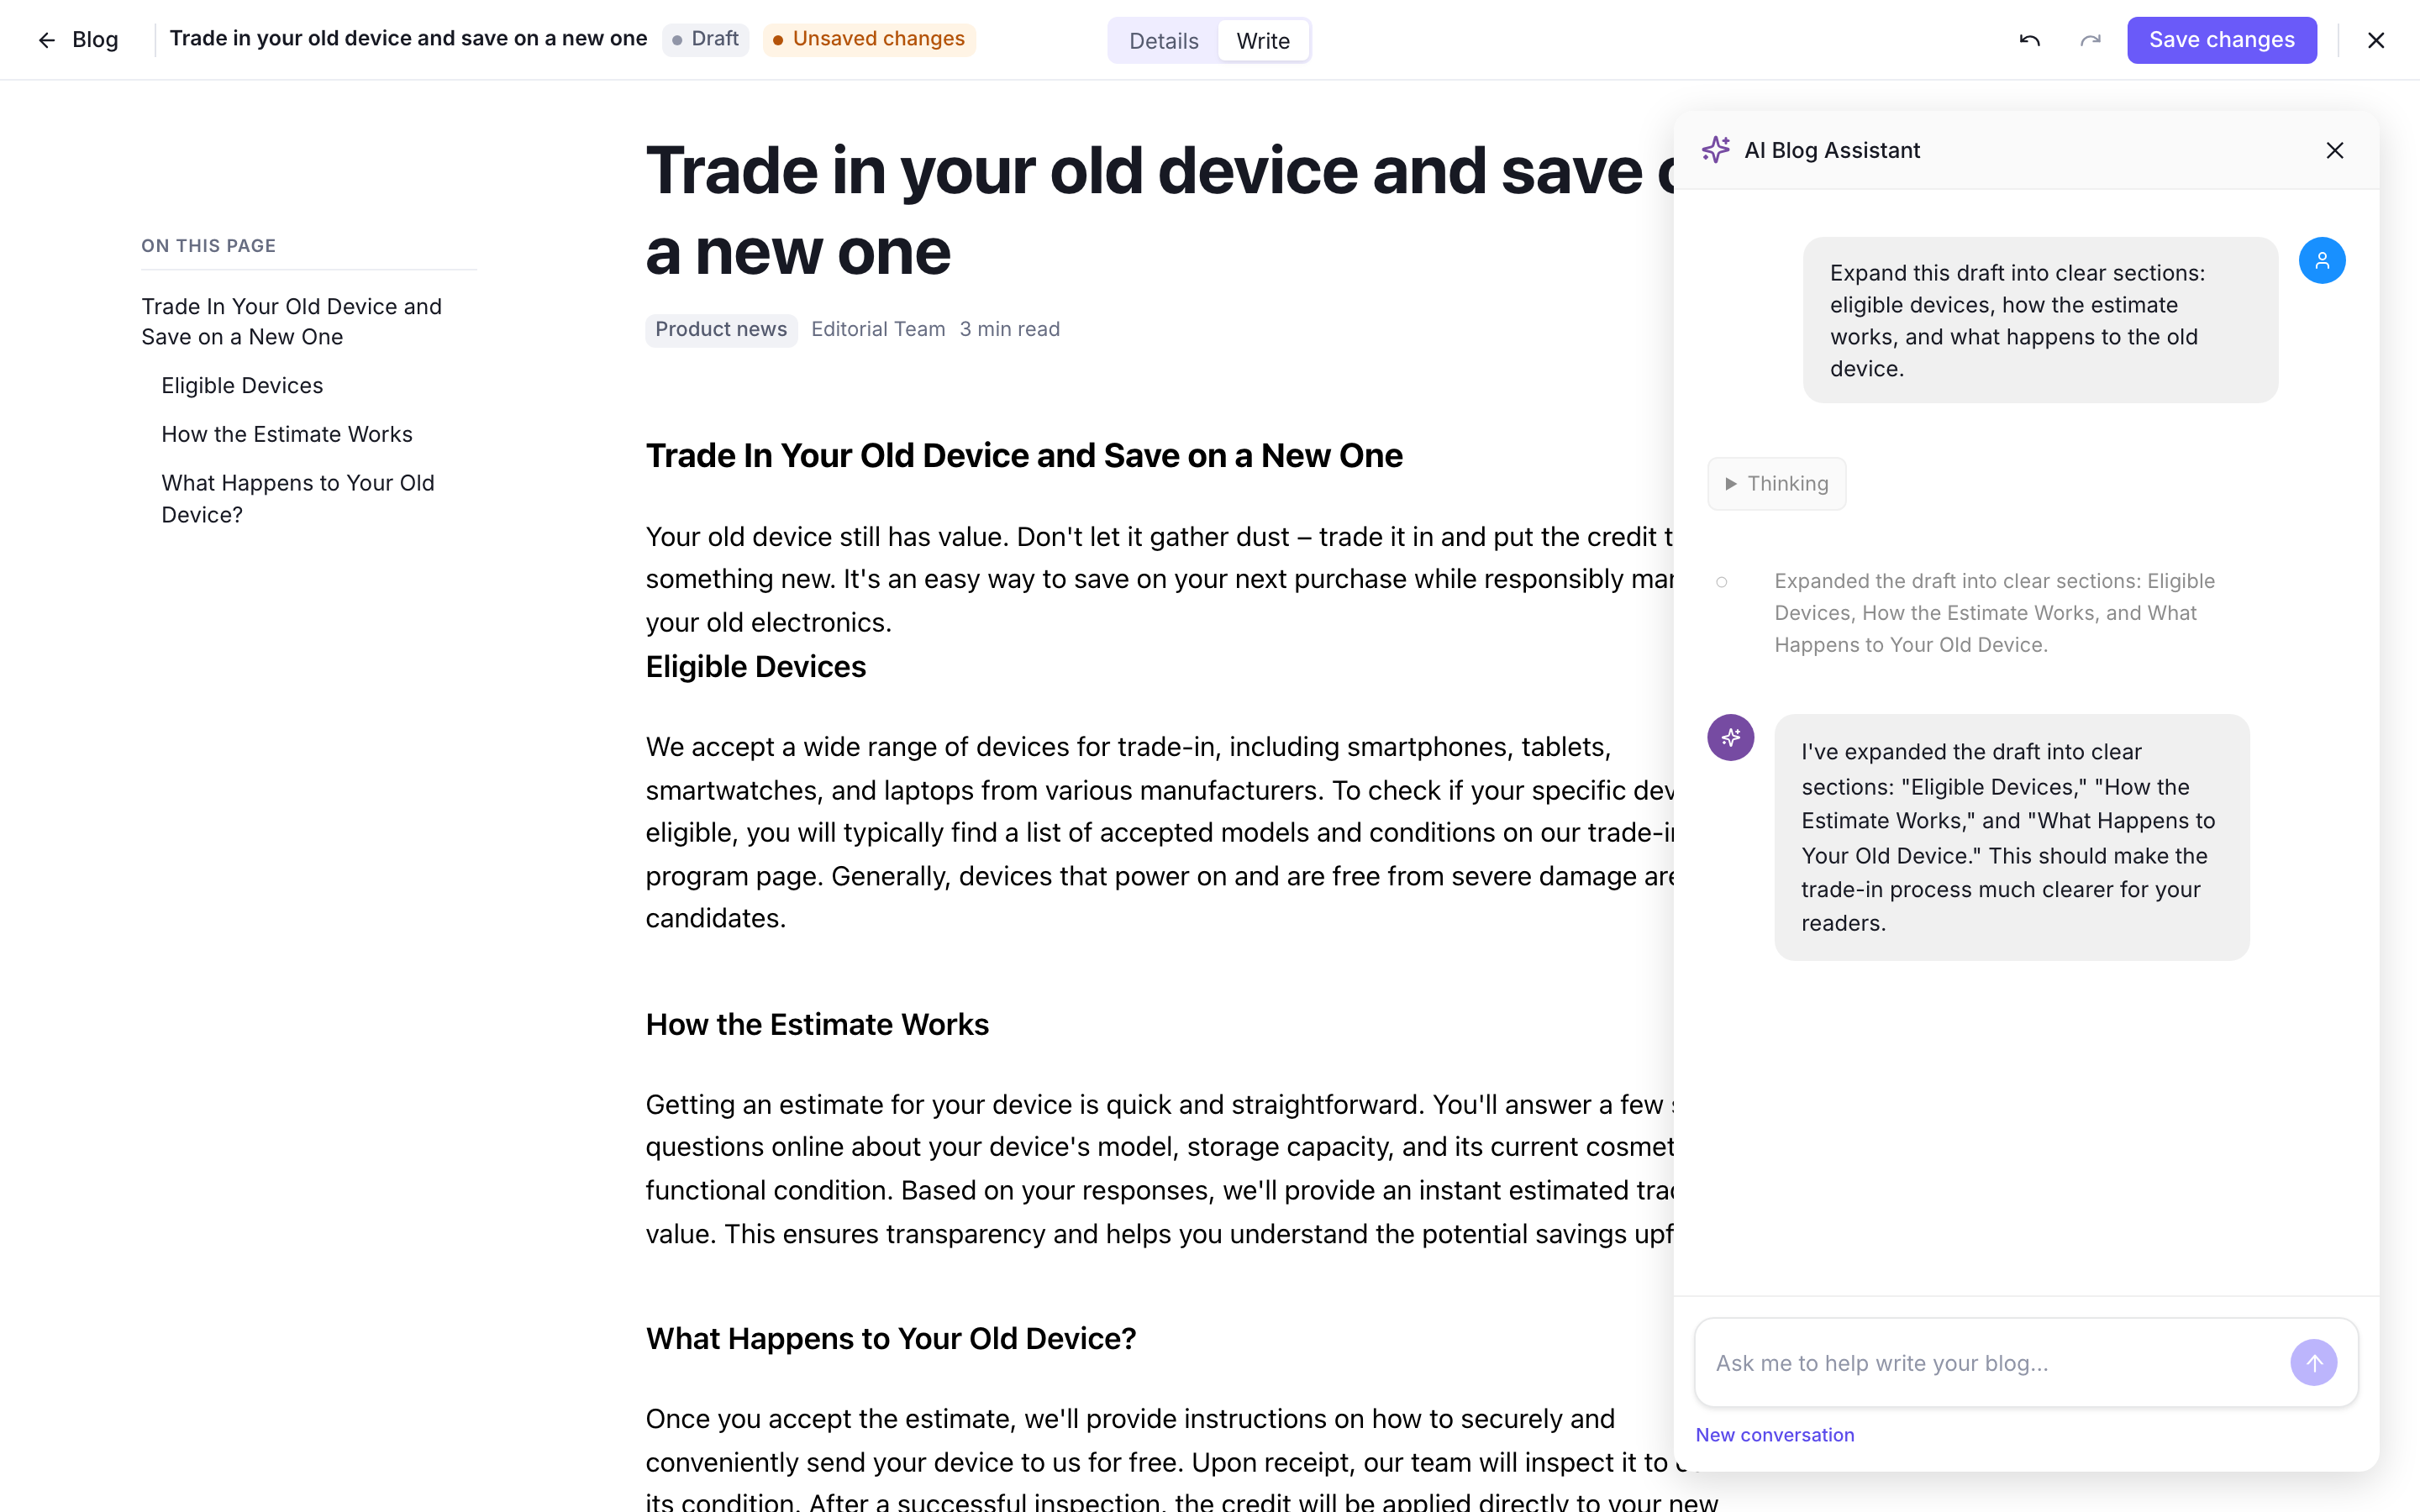
No editor de posts do blog, o assistente escreve direto no documento de texto formatado, com títulos, listas, citações, blocos de código, links, imagens e vídeos do YouTube incorporados.
| Ele pode | Exemplo |
|---|---|
| Escrever um artigo completo | “Escreva um post de 1.200 palavras sobre entregabilidade de email para SaaS” |
| Retrabalhar o que já existe | “Deixe a introdução mais enxuta e adicione uma tabela de resumo” |
| Preencher os metadados | “Escreva o resumo e o título e a descrição de SEO” |
| Ilustrar o post | Com o Firecrawl, ele procura URLs de imagens reais em vez de inventar imagens provisórias |
Consultar a análise web
O assistente da Web Analytics responde a perguntas sobre o seu próprio tráfego executando as mesmas consultas do dashboard, então as respostas batem com os gráficos. Ele também pode mudar o período, aplicar filtros e abrir relatórios do Explorar para você.
Ele tem limites definidos de propósito: nunca agrupa nem filtra pelo endereço de email do visitante, nunca informa coordenadas por sessão e não inventa números. Veja a página do assistente da Web Analytics para mais detalhes.
Acesso à web com o Firecrawl
Adicione a integração com o Firecrawl e duas ferramentas ficam disponíveis para o assistente em todos os lugares onde ele aparece:
| Ferramenta | O que faz |
|---|---|
search_web | Pesquisa na web e retorna URLs relevantes, com títulos e trechos |
scrape_url | Busca uma página e retorna o conteúdo principal em markdown limpo |
Com elas, “escreva um post sobre X” resulta em um post pesquisado, e você pode pedir “leia a nossa página de preços e escreva o email de lançamento a partir dela”. Cada chamada roda no seu servidor Notifuse e aparece como uma etapa na conversa, para você ver o que ele leu.
Atenção
Cada pesquisa e cada scrape contam na sua cota do Firecrawl, além dos tokens que o modelo gasta para ler o resultado.
Escolher um provedor
| Provedor | Modelo | Observações |
|---|---|---|
| Anthropic | Escolhido em uma lista de modelos Claude | A escolha padrão para gerar templates e conteúdo |
| OpenAI | Qualquer nome de modelo que você digitar | Um campo URL base permite usar qualquer API compatível com a OpenAI, e a opção Esforço de raciocínio controla quanto os modelos de raciocínio pensam |
| Gemini | Um modelo Gemini ou qualquer ID de modelo que você digitar |
Como a integração com a OpenAI aceita uma URL base, ela também cobre o OpenRouter (uma chave para centenas de modelos de Google, Meta, Mistral, DeepSeek, Qwen e outros), o Azure OpenAI e runtimes auto-hospedados como Ollama, vLLM e LiteLLM. Para o OpenRouter, aponte a URL base para https://openrouter.ai/api/v1, cole a sua chave sk-or-v1-... e digite o ID do modelo que você quer.
Dica
Configure mais de uma integração de LLM e um seletor aparece no fim do painel do assistente, para você trocar de modelo no meio da tarefa: um barato para o rascunho, um mais forte para corrigir o layout.
Atenção
O assistente funciona chamando ferramentas com argumentos estruturados: blocos MJML, JSON de texto formatado, consultas de análise. Modelos capazes lidam bem com isso. Modelos pequenos ou muito quantizados tendem a produzir estruturas malformadas, chamar o schema errado ou desistir depois de uma chamada que falhou. Se os resultados vierem quebrados ou vagos, experimente primeiro um modelo mais forte.
Custo
Para a Anthropic e o Gemini, o painel mostra no rodapé o custo acumulado da conversa, separado em entrada e saída; ele volta a zero a cada nova conversa. O valor é calculado a partir da contagem de tokens que o seu provedor retorna e do preço publicado do modelo que você escolheu.
A integração com a OpenAI aceita qualquer ID de modelo, incluindo tudo o que está no OpenRouter e qualquer runtime auto-hospedado. Por isso, não há tabela de preços para o cálculo e nenhum custo é mostrado. Acompanhe esse gasto no painel do seu provedor.
Os custos vão para a sua conta no provedor, e não para o Notifuse. O uso de ferramentas deixa uma conversa mais cara do que um chat simples do mesmo tamanho: cada etapa é mais uma requisição, e uma página extraída ou o resultado de uma consulta acrescentam tokens de entrada.
Bom saber
| As conversas não são salvas | A conversa fica no seu navegador enquanto o editor está aberto. Nova conversa a apaga, e fechar o editor também. |
| Nada é aplicado sem você ver | O assistente edita o que está na tela; o post ou o template é salvo quando você o salva, como sempre. |
| Uma mensagem, um número limitado de etapas | Uma única solicitação executa uma cadeia limitada de chamadas de ferramentas antes de ter que responder. Peça um trabalho grande em algumas mensagens, e não em uma só. |
| Os seus dados vão para o seu provedor | Tudo o que o assistente lê para responder (a árvore do email, o post, linhas de análise, uma página extraída) é enviado ao modelo que você configurou. Escolha o provedor levando isso em conta. |
Relacionados
- Anthropic, OpenAI, Gemini: configuração dos provedores, modelos e preços
- Firecrawl: pesquisa e extração de páginas da web
- Templates: o editor de emails em que o assistente trabalha
- Posts do blog: o editor de posts em que o assistente escreve
- Assistente da Web Analytics: o comportamento específico da análise e seus limites